Jev : l’IA qui ne parle pas, elle décide
Avec Jev, TypeSafe AI présente un modèle qui n’écrit pas de texte mais prend des décisions – en quelques millisecondes et en indiquant son degré d’incertitude. Ce qu’il y a derrière, où il sert les PME et où il ne sert pas.
Lundi, 8 h 12. La boîte de réception d’une entreprise artisanale contient 140 nouveaux messages : demandes de devis, réclamations, factures, une candidature, trois newsletters. Chacun exige une décision – où le classer, avec quelle urgence, qui s’en charge ? Aucun n’exige une conversation.
C’est précisément ce vide qu’entend combler un modèle apparu à la mi-septembre 2026. Il s’appelle Jev, vient de la start-up américaine TypeSafe AI et possède une propriété inhabituelle dans le paysage actuel de l’IA : il ne sait pas converser. Il n’écrit pas de paragraphes, ne résume rien et ne se justifie pas. Il répond à une question fixée à l’avance – et indique à quel point il est sûr de lui.
Derrière TypeSafe se trouve Diogo Almeida, coauteur de l’article InstructGPT de 2022, que heise présente comme un fondement important de ChatGPT. Fondée en 2024, l’entreprise a levé 40 millions de dollars en amorçage selon heise et propose Jev en accès anticipé via une API hébergée depuis septembre 2026. Quiconque veut comprendre où va l’automatisation dans les PME devrait examiner ce modèle de près – avec curiosité, mais aussi avec le recul nécessaire.
Deux façons de penser
Le nom de cette classe de modèles n’est pas un hasard. TypeSafe qualifie Jev de « System One model » et emprunte ainsi une image au psychologue et prix Nobel Daniel Kahneman. Dans « Thinking, Fast and Slow » (2011 ; en français « Système 1 / Système 2 »), il distingue deux modes de pensée : le système 1 est rapide, automatique et sans effort – il reconnaît un visage en colère avant que nous le regardions consciemment. Le système 2 est lent, coûteux et délibéré – il calcule 17 × 24 ou pèse un contrat.
Dans cette métaphore, les grands modèles de langage ressemblent plutôt au système 2 : ils « pensent à voix haute », produisent une réponse jeton par jeton et peuvent argumenter, rédiger, programmer. C’est puissant – et tout simplement surdimensionné pour bien des décisions quotidiennes. Pour savoir si un e-mail est une réclamation, nul besoin d’une dissertation. Jev est une tentative de faire du jugement rapide et intuitif un produit à part entière.
Ce qu’est Jev – et ce qu’il n’est pas
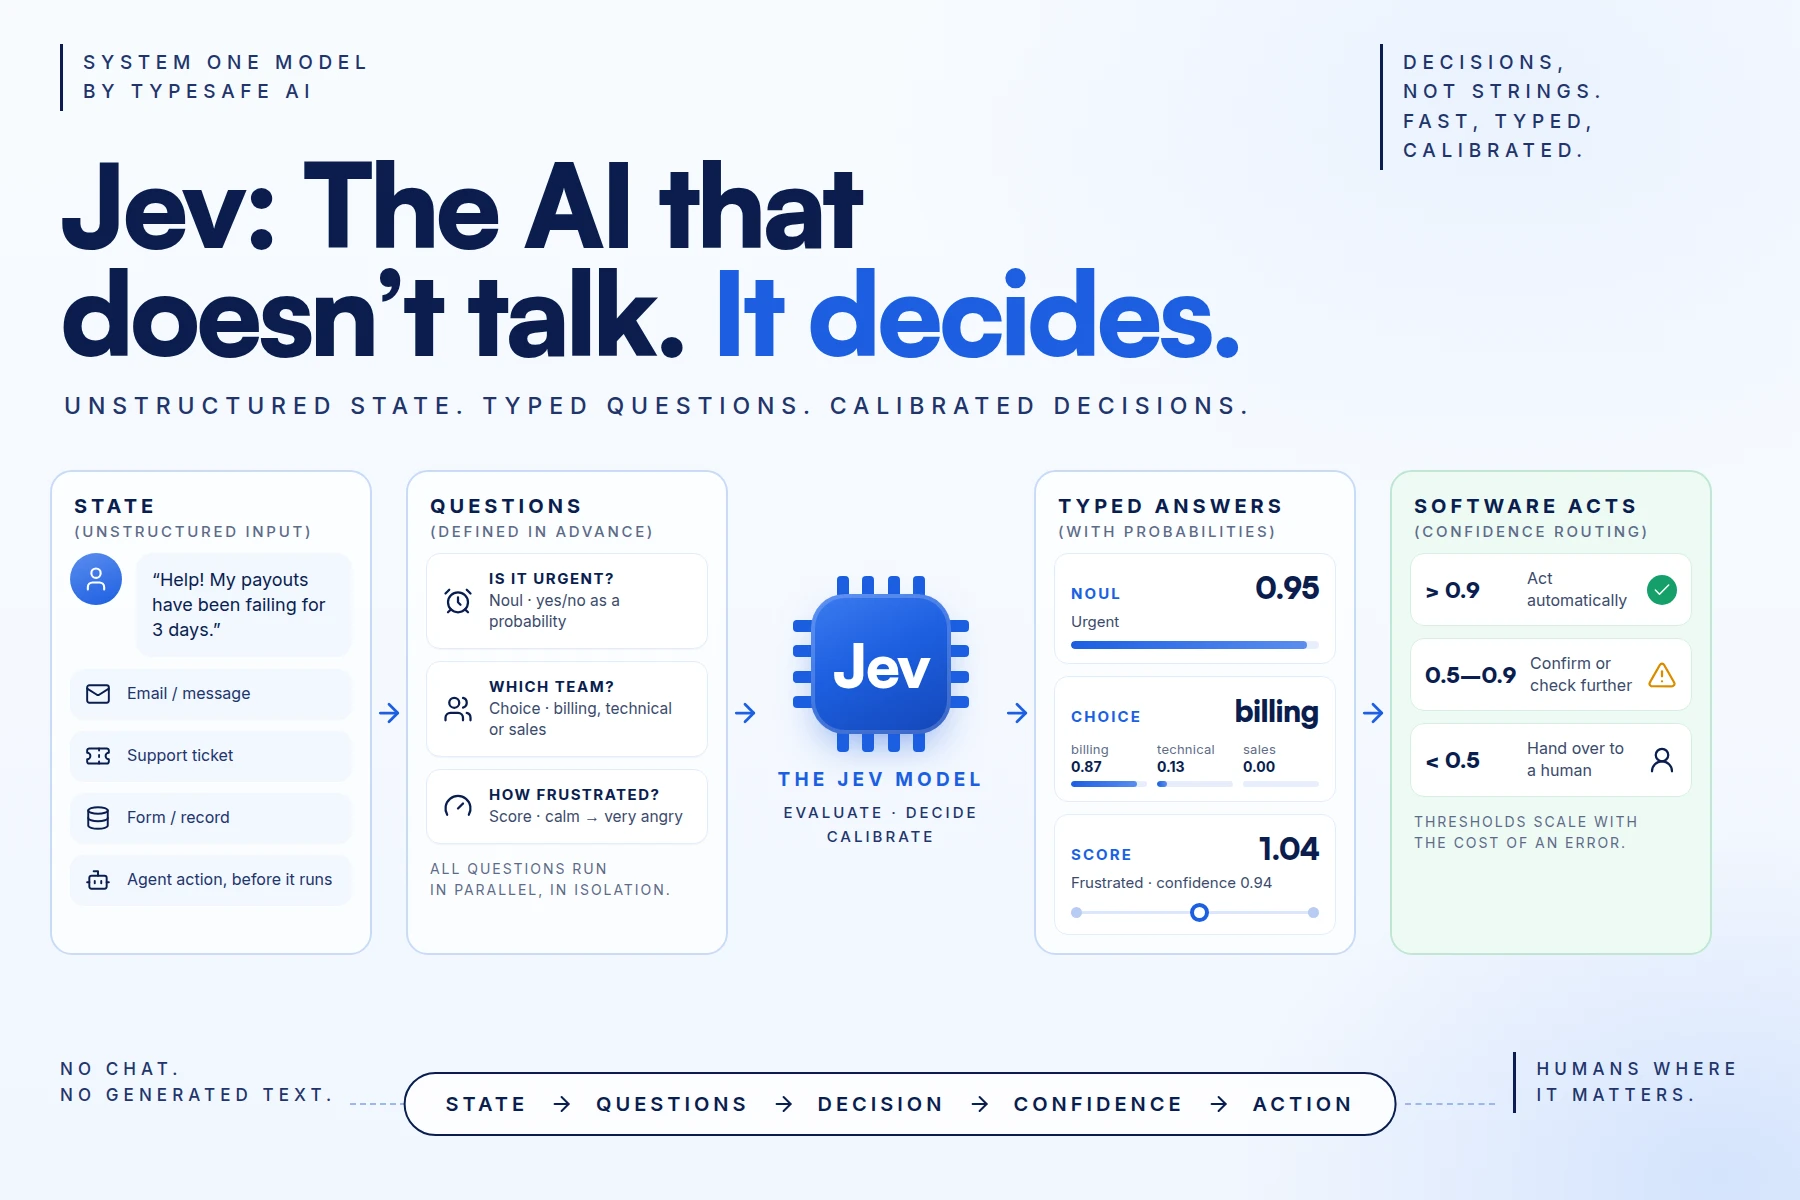
Techniquement, Jev reçoit deux choses : un état – par exemple le texte d’une demande client, un ticket ou un enregistrement – et une ou plusieurs questions à son sujet. Vous fixez les réponses possibles à l’avance. Ce qui revient n’est pas de la prose, mais un résultat typé que le logiciel peut traiter directement. La documentation connaît trois formes de base :
- Noul – une affirmation oui/non, exprimée comme une probabilité entre 0 et 1 (« Ce message est-il urgent ? »).
- Choice – un choix dans une liste fermée, avec une probabilité par option (« Ventes, technique ou comptabilité ? »).
- Score – une note sur une échelle que vous définissez vous-même (« calme – agacé – très en colère »).
À chaque réponse, Jev associe une confiance : un nombre entre 0 et 1 dérivé de la distribution de probabilités. Si la distribution est concentrée sur une option, le modèle est sûr de lui ; si elle est dispersée, il ne l’est pas. Selon TypeSafe, ce comportement a été entraîné avec une méthode maison baptisée « Reinforcement Learning for Calibrated Decisions » (RLCD). L’idée : récompenser non seulement la bonne décision, mais aussi une estimation honnête de sa propre certitude.
Toutes les questions portant sur un état sont évaluées en parallèle et indépendamment les unes des autres. Selon LangChain, une question supplémentaire ne change donc presque rien au temps de réponse – dix évaluations d’un e-mail ne prennent guère plus de temps qu’une seule.
Ce que Jev n’est pas compte tout autant : ni un chatbot, ni un générateur de texte, ni un substitut à un modèle de langage. Sa propre documentation le dit sans détour – le modèle n’est pas entraîné à produire du texte et s’en sort mal quand on l’y force.
Les chiffres – et qui les a mesurés
- 70–500 msTemps de réponse par requêteselon l’éditeur, selon l’usage
- 0,042 $par million de jetons d’entréesortie gratuite
- 32 000jetons de fenêtre de contexteversion jev-1.13.0
- 3types de réponseNoul, Choice, Score
Sur son propre site, TypeSafe mise sur les superlatifs : sur les tâches « System One », Jev serait 193,6 fois plus rapide et 444,6 fois moins cher qu’un modèle de langage, avec un temps de réponse de 0,114 seconde au lieu de 8,566. Des chiffres impressionnants – qui méritent un second regard.
Car c’est l’éditeur lui-même qui les a mesurés, comme le souligne expressément heise. Selon heise, la référence des « bonnes » réponses était la moyenne des réponses de deux grands modèles de langage, GPT-6 Astra et Claude Fable 5.1. KDnuggets ajoute que la précision de 68 % avancée par TypeSafe repose elle aussi sur ces réponses de référence, et non sur une vérité vérifiée de manière indépendante. Autrement dit : Jev a été évalué sur sa capacité à imiter de grands modèles – pas sur la fréquence à laquelle il a raison dans votre entreprise.
Cela ne rend pas ces chiffres inutiles. Qu’un modèle spécialisé soit plus rapide et moins cher qu’un généraliste de plusieurs ordres de grandeur sur une tâche étroite est plausible. Mais aucune fiche technique ne dira s’il est assez bon pour vos décisions. Seules vos propres données le diront.
À quoi ressemble une décision
Un exemple tiré de la documentation de Cloudflare, où Jev est disponible comme modèle sur la plateforme Workers AI, illustre le principe. Une cliente écrit : « À l’aide ! Mes virements échouent depuis trois jours. » Le logiciel pose trois questions à la fois :
const response = await env.AI.run("typesafe/jev", {
  state: "Help! My payouts have been failing for 3 days.",
  questions: {
    is_urgent: {
      type: "noul",
      instructions: "Does this convey urgency?",
      criteria: { true: "Explicitly time-sensitive", false: "No urgency expressed" },
    },
    department: {
      type: "choice",
      instructions: "Which team should handle this?",
      criteria: {
        billing: "Payments, invoicing, refunds",
        technical: "Bugs, outages, integrations",
        sales: "Pricing, upgrades, new accounts",
      },
    },
    frustration: {
      type: "score",
      instructions: "How frustrated is the customer?",
      criteria: ["Calm", "Frustrated", "Very angry"],
    },
  },
});

// Response (abridged):
// is_urgent   → noul: 0.95
// department  → choice: "billing", confidence: 0.8
//               probabilities: { billing: 0.87, technical: 0.13, sales: 0 }
// frustration → score: 1.04 ("Frustrated"), confidence: 0.94
Le résultat n’est pas de la prose mais une structure de données : urgent à 95 %, facturation à 87 %, agacée avec une confiance élevée. Un programme peut réagir immédiatement – prioriser le ticket, l’attribuer à la bonne équipe, prévenir un responsable si nécessaire.
C’est avec la confiance que cela devient intéressant. TypeSafe recommande trois zones : au-dessus de 0,9, le logiciel peut agir automatiquement. Entre 0,5 et 0,9, la prudence s’impose, par exemple une confirmation ou une vérification supplémentaire. En dessous de 0,5, il ne doit pas agir du tout, mais passer la main à un humain ou à un autre système. Plus important que les valeurs exactes est le principe qui les sous-tend : le seuil dépend du préjudice qu’une erreur causerait. Une newsletter peut être classée avec moins de certitude qu’une résiliation.
Là où cela fonctionne pour les PME
Jev donne le meilleur de lui-même là où trois conditions se rencontrent : la décision se répète souvent, les réponses possibles peuvent être énumérées à l’avance, et une erreur isolée peut être corrigée. Pour les PME, cela ouvre des cas d’usage évidents :
- Trier la boîte de réception : demande, réclamation, facture, candidature ou publicité – et avec quelle urgence ?
- Préqualifier les demandes : le projet correspond-il à votre offre, et dans quelle fourchette de budget se situe-t-il ?
- Router les tickets de support : vers la technique, les ventes ou la comptabilité, avec une priorité.
- Analyser les avis et retours clients : tonalité, thème, action requise.
- Garde-fous pour assistants IA : avant qu’un modèle de langage exécute une action, Jev vérifie si elle est risquée – un schéma décrit par LangChain.
Ce dernier point montre bien la direction prise. Jev est moins un concurrent qu’un complice des grands modèles de langage. LangChain décrit ainsi la répartition des rôles : un modèle de langage pour le raisonnement ouvert et la rédaction, Jev pour les décisions rapides et structurées entre les deux. Un assistant de service client pourrait donc déterminer avec Jev qui est responsable et quel est le degré d’urgence – et ne laisser un modèle plus coûteux rédiger une réponse que lorsqu’elle est vraiment nécessaire.
Là où cela ne fonctionne pas
TypeSafe se montre remarquablement transparent sur les faiblesses. Sous l’intitulé « model jaggedness », l’éditeur documente lui-même les situations où Jev 1.13 devient peu fiable :
- Calcul et dénombrement – le modèle n’est explicitement « pas une calculatrice ».
- Logique des dates et des heures – les dates sont lues comme du texte, pas comme des grandeurs ordonnées.
- Logique imbriquée, comme les doubles négations ou les raisonnements en plusieurs étapes.
- Beaucoup de contexte non pertinent, qui fait baisser la précision.
- Des entrées manipulées qui orientent le jugement par des instructions injectées.
- Des contradictions entre instructions et critères, et une lecture littérale plutôt que selon l’intention.
S’y ajoute un malentendu que KDnuggets résume parfaitement. TypeSafe promet « zéro hallucination » – ce qui n’est vrai qu’au sens étroit : Jev ne peut pas inventer une réponse en dehors des options fournies. À l’intérieur de ces options, en revanche, il peut tout à fait se tromper.
Zéro sortie hors schéma – pas zéro décision erronée.
Enfin, la transparence : Jev ne motive pas ses décisions, et heise y voit une question ouverte. Pour votre entreprise, cela signifie que si un client veut savoir pourquoi sa demande a été reléguée au second plan, le modèle ne fournit aucune explication. C’est à vos processus de la fournir.
Aucune fiche technique ne remplace votre propre mesure. Avant que Jev ne décide dans votre entreprise, testez-le sur 100 à 200 cas réels évalués par des humains – vous saurez alors quel seuil de confiance tient pour quelle action.
Le droit : qui fait décider reste responsable
En Europe, un modèle qui décide touche deux corps de règles. Le premier est le RGPD. Son article 22 donne aux personnes le droit de ne pas faire l’objet d’une décision fondée exclusivement sur un traitement automatisé produisant des effets juridiques à leur égard ou les affectant de manière significative de façon similaire. La Cour de justice de l’Union européenne en a montré la portée dans son arrêt SCHUFA de décembre 2023 (C-634/21) : même un score calculé automatiquement peut constituer une telle décision s’il joue un rôle déterminant dans le résultat.
Concrètement : pré-trier un e-mail ne pose pas de problème. Écarter automatiquement une candidature, ou refuser des conditions à un client sur la seule base du score d’un modèle, en pose. Un humain doit alors intervenir dans la décision – un humain qui examine réellement le résultat au lieu de simplement l’entériner.
Le second corps de règles est le règlement européen sur l’intelligence artificielle (AI Act). Il classe certains usages comme à haut risque, dont la sélection de candidats et l’évaluation de la solvabilité. Avec l’« omnibus numérique », le règlement (UE) 2026/1744, les obligations applicables à ces systèmes autonomes à haut risque ont été reportées au 2 décembre 2027. Mais reporté ne veut pas dire annulé : qui automatise aujourd’hui un processus de recrutement avec Jev construit un système qui devra satisfaire à des exigences strictes à partir de décembre 2027.
Reste la protection des données au sens strict. TypeSafe s’engage à ne pas entraîner ses modèles sur les données des utilisateurs et propose une conservation nulle des données (zero data retention) – mais uniquement à ses clients entreprise. Quiconque envoie des données personnelles à l’API a besoin d’un contrat de sous-traitance et doit vérifier où elles sont traitées. Avec un fournisseur basé à San Francisco, ce n’est pas une simple formalité.
Une règle de décision pour les modèles de décision
Cinq questions permettent de savoir si Jev convient à votre entreprise – dans cet ordre :
- La décision peut-elle s’écrire comme une règle fixe ? Alors une règle vaut mieux – déterministe, gratuite, traçable.
- L’espace des réponses est-il fermé ? Si vous ne pouvez pas énumérer les réponses possibles à l’avance, un modèle de langage est le meilleur outil.
- La décision se répète-t-elle assez souvent ? Dix cas par mois ne justifient pas une automatisation ; dix mille, oui.
- Que coûte une erreur – et qui touche-t-elle ? Si elle affecte des personnes de manière significative, un humain doit intervenir.
- Pouvez-vous mesurer la qualité ? Sans jeu de test propre, tout seuil de confiance reste une supposition.
Conclusion : la révolution silencieuse
Jev n’est pas une percée au sens d’une intelligence nouvelle. La classification existe depuis des décennies, et KDnuggets a raison de mettre en garde contre le vocabulaire de la révolution. Ce qui est intéressant est ailleurs : une capacité jusqu’ici enfermée dans des modèles généralistes coûteux et bavards est extraite, réduite et assortie d’une indication honnête de sa propre incertitude. C’est le genre de progrès qui arrive réellement dans les entreprises.
Pour les PME, l’opportunité ne consiste pas à automatiser le plus possible, mais à automatiser les bonnes décisions : les fréquentes, clairement délimitées, corrigibles. Qui commence par là, mesure rigoureusement et laisse les humains décider dès qu’il s’agit d’humains obtient avec des modèles comme Jev un outil qui se tait enfin – et décide, tout simplement.
Sources
- AI model “Jev” to make machines decide fasterTomislav Bezmalinović · heise online · 2026-09-17
- Home – TypeSafe AITypeSafe AI · 2026
- Primitives: Choice, Score, NoulTypeSafe AI Docs
- ConfidenceTypeSafe AI Docs
- Model jaggedness: jev-1.13TypeSafe AI Docs
- LegalTypeSafe AI Docs
- Jev (typesafe) – model documentationCloudflare Workers AI Docs
- What Is Jev? A Guide to TypeSafe AI’s System One ModelSydney Runkle, Hunter Lovell · LangChain Blog · 2026-09-17
- What Everyone Is Getting Wrong About TypeSafe AI’s JevAbid Ali Awan · KDnuggets · 2026-09-21
- Training language models to follow instructions with human feedbackLong Ouyang, Jeff Wu, Xu Jiang, Diogo Almeida et al. · arXiv:2203.02155 · 2022
- Thinking, Fast and SlowDaniel Kahneman · Farrar, Straus and Giroux · 2011
- Règlement (UE) 2016/679 (règlement général sur la protection des données), art. 22Journal officiel de l’Union européenne · 2016-04-27
- Arrêt dans l’affaire C-634/21 (SCHUFA Holding – Scoring)Cour de justice de l’Union européenne · 2023-12-07
- Règlement (UE) 2024/1689 (règlement sur l’intelligence artificielle)Journal officiel de l’Union européenne · 2024-06-13
- Règlement (UE) 2026/1744 (omnibus numérique sur l’IA)Journal officiel de l’Union européenne · 2026-07-24
Tous les liens consultés le 23 septembre 2026. Les affirmations de l’éditeur sont signalées comme telles dans le texte et n’ont pas été vérifiées de manière indépendante.
Un projet similaire en tête ?
Parlez-m'en – le premier échange est gratuit.
Me contacter